Ученые ННГУ имени Лобачевского совместно с итальянскими коллегами представили модель искусственного интеллекта, прогнозирующую риск смерти у пациентов с диабетом. Результаты исследования были опубликованы в журнале Frontiers in Endocrinology в октябре 2025 года.
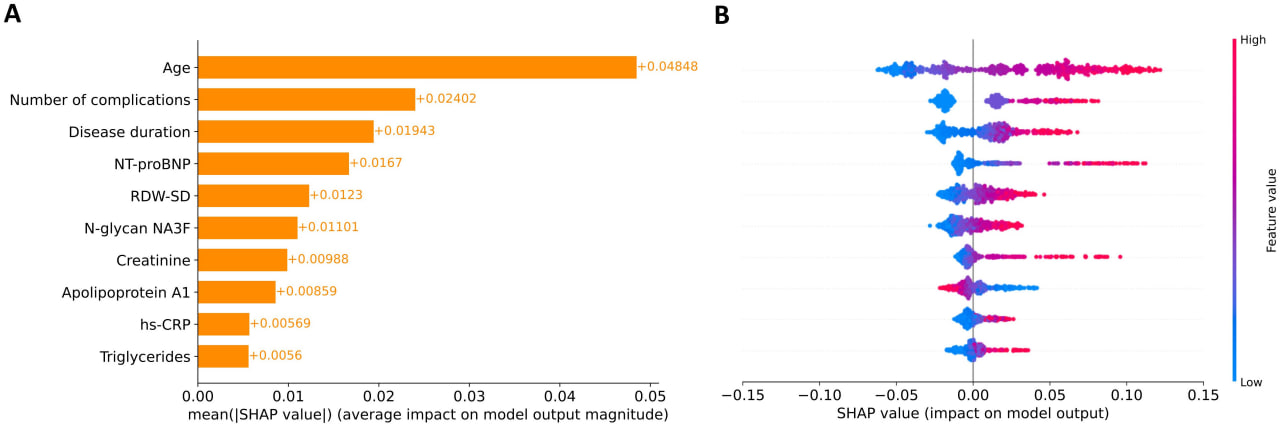
Модель создана Институтом биологии старения и Исследовательским центром в сфере искусственного интеллекта ННГУ. Алгоритм обучали на данных 554 пациентов с диабетом. Наблюдение за этой когортой велось 17 лет. Система проанализировала сотни клинических и лабораторных параметров. В результате было отобрано десять ключевых биомаркеров, которые определяют риски летального исхода. Для объяснения выводов использовался метод SHAP (SHapley Additive exPlanations). Этот метод показывает, какой вклад в итоговый прогноз вносит каждый конкретный фактор. Точность прогноза выживаемости на протяжении всего периода наблюдения достигла 84%.
Автор исследования Михаил Иванченко в комментарии для ТАСС 9 декабря 2025 года пояснил, как система определяет ключевые факторы риска. «Благодаря методу интерпретации прогноза искусственного интеллекта можно выделить взаимосвязи между десятками параметров состояния пациента. Например, мы увидели, что возраст, продолжительность болезни и количество осложнений — самые мощные факторы риска смерти при диабете», — сообщил Иванченко. Он также отметил практическую ценность объяснимости: «Наш подход позволяет составить персональную карту рисков для конкретного пациента. К примеру, модель может показать, что у пациента высокий риск смерти на 68% сложился в первую очередь из-за повышенного креатинина, возраста и четырех диабетических осложнений».
Профессор биостатистики Университета Бирмингема Патрик Райли в исследовании, опубликованном в журнале The BMJ в январе 2024 года, указывает, что для создания надежных прогностических моделей смертности требуется не менее 258 случаев летального исхода. В работе ученых ННГУ зафиксировано лишь 202 случая смерти, что, согласно расчетам Райли, может указывать на необходимость переобучения модели на новых данных. Систематический анализ, опубликованный в BMJ, показал, что около 88% исследований моделей машинного обучения в медицине имеют высокий риск смещения1 именно из-за малых выборок и проблем с валидацией.
Модель ученых ННГУ была создана и протестирована на данных, собранных в одном итальянском центре. Как указывают авторы работы, ее применимость на группах с иными демографическими характеристиками и стандартами лечения не проверялась. Исследование доктора медицинских наук Нью-Йоркского университета Харвинита Сингха для PLOS Digit Health (2024) демонстрирует, что отсутствие внешней валидации является серьезным методологическим пробелом. Ученый отмечает, что только 20% медицинских моделей ИИ, успешно прошедших внутреннее тестирование, сохраняют точность при проверке на наборах данных из других клиник или регионов.
Точность модели может снизиться со временем из-за «дрейфа данных»2 – различий между данными для обучения и реальными клиническими данными. Алгоритм ННГУ обучали на информации 2003–2006 годов. С тех пор стандарты лечения диабета изменились, и прежние закономерности могли устареть. Работа руководителя лаборатории Управления по контролю за продуктами и лекарствами США (FDA) Беркмана Сахинера, опубликованная в The British Journal of Radiology в 2023 году, подтверждает, что прогностическая сила клинических моделей ИИ со временем падает, что требует их периодического переобучения на актуальных данных.
Внедрение ИИ-моделей в медицинскую практику создает правовые сложности. Как отмечается в исследовании, опубликованном в журнале Humanities and Social Sciences Communications в 2024 году, врач несет полную юридическую ответственность при использовании рекомендаций систем искусственного интеллекта. Специалист рискует как при следовании ошибочному прогнозу ИИ, так и при его игнорировании. Авторы подчеркивают, что разработчики определяют ИИ как вспомогательный инструмент, что снимает с них ответственность и переносит все риски на лечащего врача.
Планы разработчиков включают дальнейшее тестирование модели. Михаил Иванченко в материале для медиацентра ННГУ отметил, что следующим шагом будет проверка алгоритма на независимых данных из других регионов, включая Россию.
- Риск смещения (предвзятости) в системах искусственного интеллекта (ИИ) — это ситуация, когда система ошибочно отдаёт преимущество одним группам пользователей перед другими из-за особенностей данных или принципов работы алгоритма. В результате решения системы могут быть нечестными и даже дискриминирующими.
- Дрейф данных — это ситуация, когда статистические свойства входных данных для модели меняются со временем по сравнению с обучающими данными, на которых она была построена. Это может привести к снижению производительности модели, неточным прогнозам и даже сбоям.